1.创建一个文件夹
最好用英文命名,可参考如下:
bili_up_spider.py:爬虫程序
photo(需要提前创建):保存封面照片
bvids.txt(无需提前创建):储存所有视频的BV号
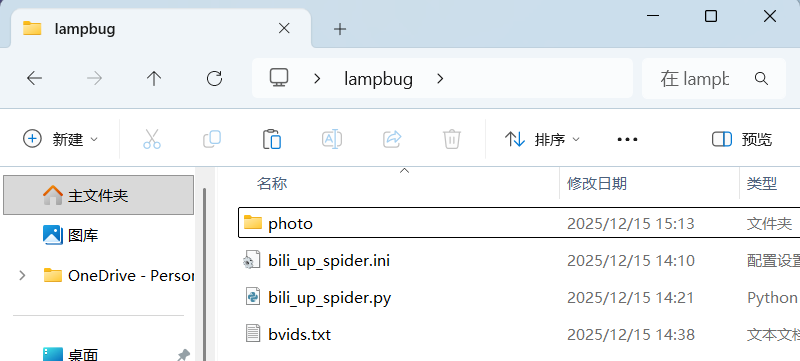
2.python程序
2.1 安装依赖(只需要 requests):
在命令行cmd中输入以下指令安装
pip install requests可以使用以下指令查看是否已安装requests
pip show requests2.2完整程序(直接复制即可)
import os
import re
import time
import random
import hashlib
import urllib.parse
from pathlib import Path
from urllib.parse import urlparse

import requests

# ========= 基本配置 =========
VMID = 363112755
OUT_TXT = "bvids.txt"
PHOTO_DIR = "photo"

WBI_API = "https://api.bilibili.com/x/space/wbi/arc/search"
NAV_API = "https://api.bilibili.com/x/web-interface/nav"

# ========= 在这里填你的 Cookie =========
SESSDATA = "YOUR_SESSDATA_HERE"
BILI_JCT = "YOUR_BILI_JCT_HERE"

COOKIE = f"SESSDATA={SESSDATA}; bili_jct={BILI_JCT}"

HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/120.0.0.0 Safari/537.36"
    ),
    "Accept": "application/json, text/plain, */*",
    "Referer": "https://www.bilibili.com/",
    "Cookie": COOKIE,
}

# ========= 风控必需 dm_* =========
DM_PARAMS = {
    "dm_img_list": "[]",
    "dm_img_str": "V2ViR0wgMS",
    "dm_cover_img_str": "SW50ZWwoUikgSEQgR3JhcGhpY3NJbnRlbA",
}

# ========= WBI =========
MIXIN_KEY_ENC_TAB = [
    46,47,18,2,53,8,23,32,15,50,10,31,58,3,45,35,
    27,43,5,49,33,9,42,19,29,28,14,39,12,38,41,13,
    37,48,7,16,24,55,40,61,26,17,0,1,60,51,30,4,
    22,25,54,21,56,59,6,63,57,62,11,36,20,34,44,52
]


def get_ext(url):
    try:
        ext = os.path.splitext(urlparse(url).path)[1]
        return ext if ext else ".jpg"
    except:
        return ".jpg"


def get_wbi_keys(session):
    r = session.get(NAV_API, headers=HEADERS, timeout=15)
    r.raise_for_status()
    j = r.json()
    wbi = j["data"]["wbi_img"]
    img_key = wbi["img_url"].split("/")[-1].split(".")[0]
    sub_key = wbi["sub_url"].split("/")[-1].split(".")[0]
    return img_key, sub_key


def gen_mixin_key(img_key, sub_key):
    raw = img_key + sub_key
    return "".join(raw[i] for i in MIXIN_KEY_ENC_TAB)[:32]


def enc_wbi(params, img_key, sub_key):
    mixin = gen_mixin_key(img_key, sub_key)
    params["wts"] = int(time.time())
    params = dict(sorted(params.items()))
    query = urllib.parse.urlencode(params)
    params["w_rid"] = hashlib.md5((query + mixin).encode()).hexdigest()
    return params


def main():
    base = Path(__file__).parent
    photo_dir = base / PHOTO_DIR
    photo_dir.mkdir(exist_ok=True)

    bvids = []
    info = []

    with requests.Session() as sess:
        img_key, sub_key = get_wbi_keys(sess)
        pn, ps = 1, 50

        while True:
            params = {
                "mid": VMID,
                "pn": pn,
                "ps": ps,
                "order": "pubdate",
                **DM_PARAMS,
            }
            params = enc_wbi(params, img_key, sub_key)

            r = sess.get(WBI_API, headers=HEADERS, params=params, timeout=15)
            r.raise_for_status()
            j = r.json()

            if j["code"] != 0:
                raise RuntimeError(j)

            vlist = j["data"]["list"]["vlist"]
            if not vlist:
                break

            for v in vlist:
                bvid = v["bvid"]
                cover = v["pic"]
                bvids.append(bvid)
                info.append((bvid, cover))

            if pn * ps >= j["data"]["page"]["count"]:
                break

            pn += 1
            time.sleep(random.uniform(1.0, 1.8))

    with open(base / OUT_TXT, "w", encoding="utf-8") as f:
        f.write("\n".join(bvids))

    with requests.Session() as sess:
        for bvid, cover in info:
            path = photo_dir / f"{bvid}{get_ext(cover)}"
            if path.exists():
                continue
            r = sess.get(cover, headers=HEADERS, timeout=20)
            with open(path, "wb") as f:
                f.write(r.content)
            print(f"[OK] {bvid}")
            time.sleep(random.uniform(0.3, 0.6))

    print("\n========== 完成 ==========")
    print(f"BV号数量:{len(bvids)}")


if __name__ == "__main__":
    main()
3.获取SESSDATA 和 BILI_JCT
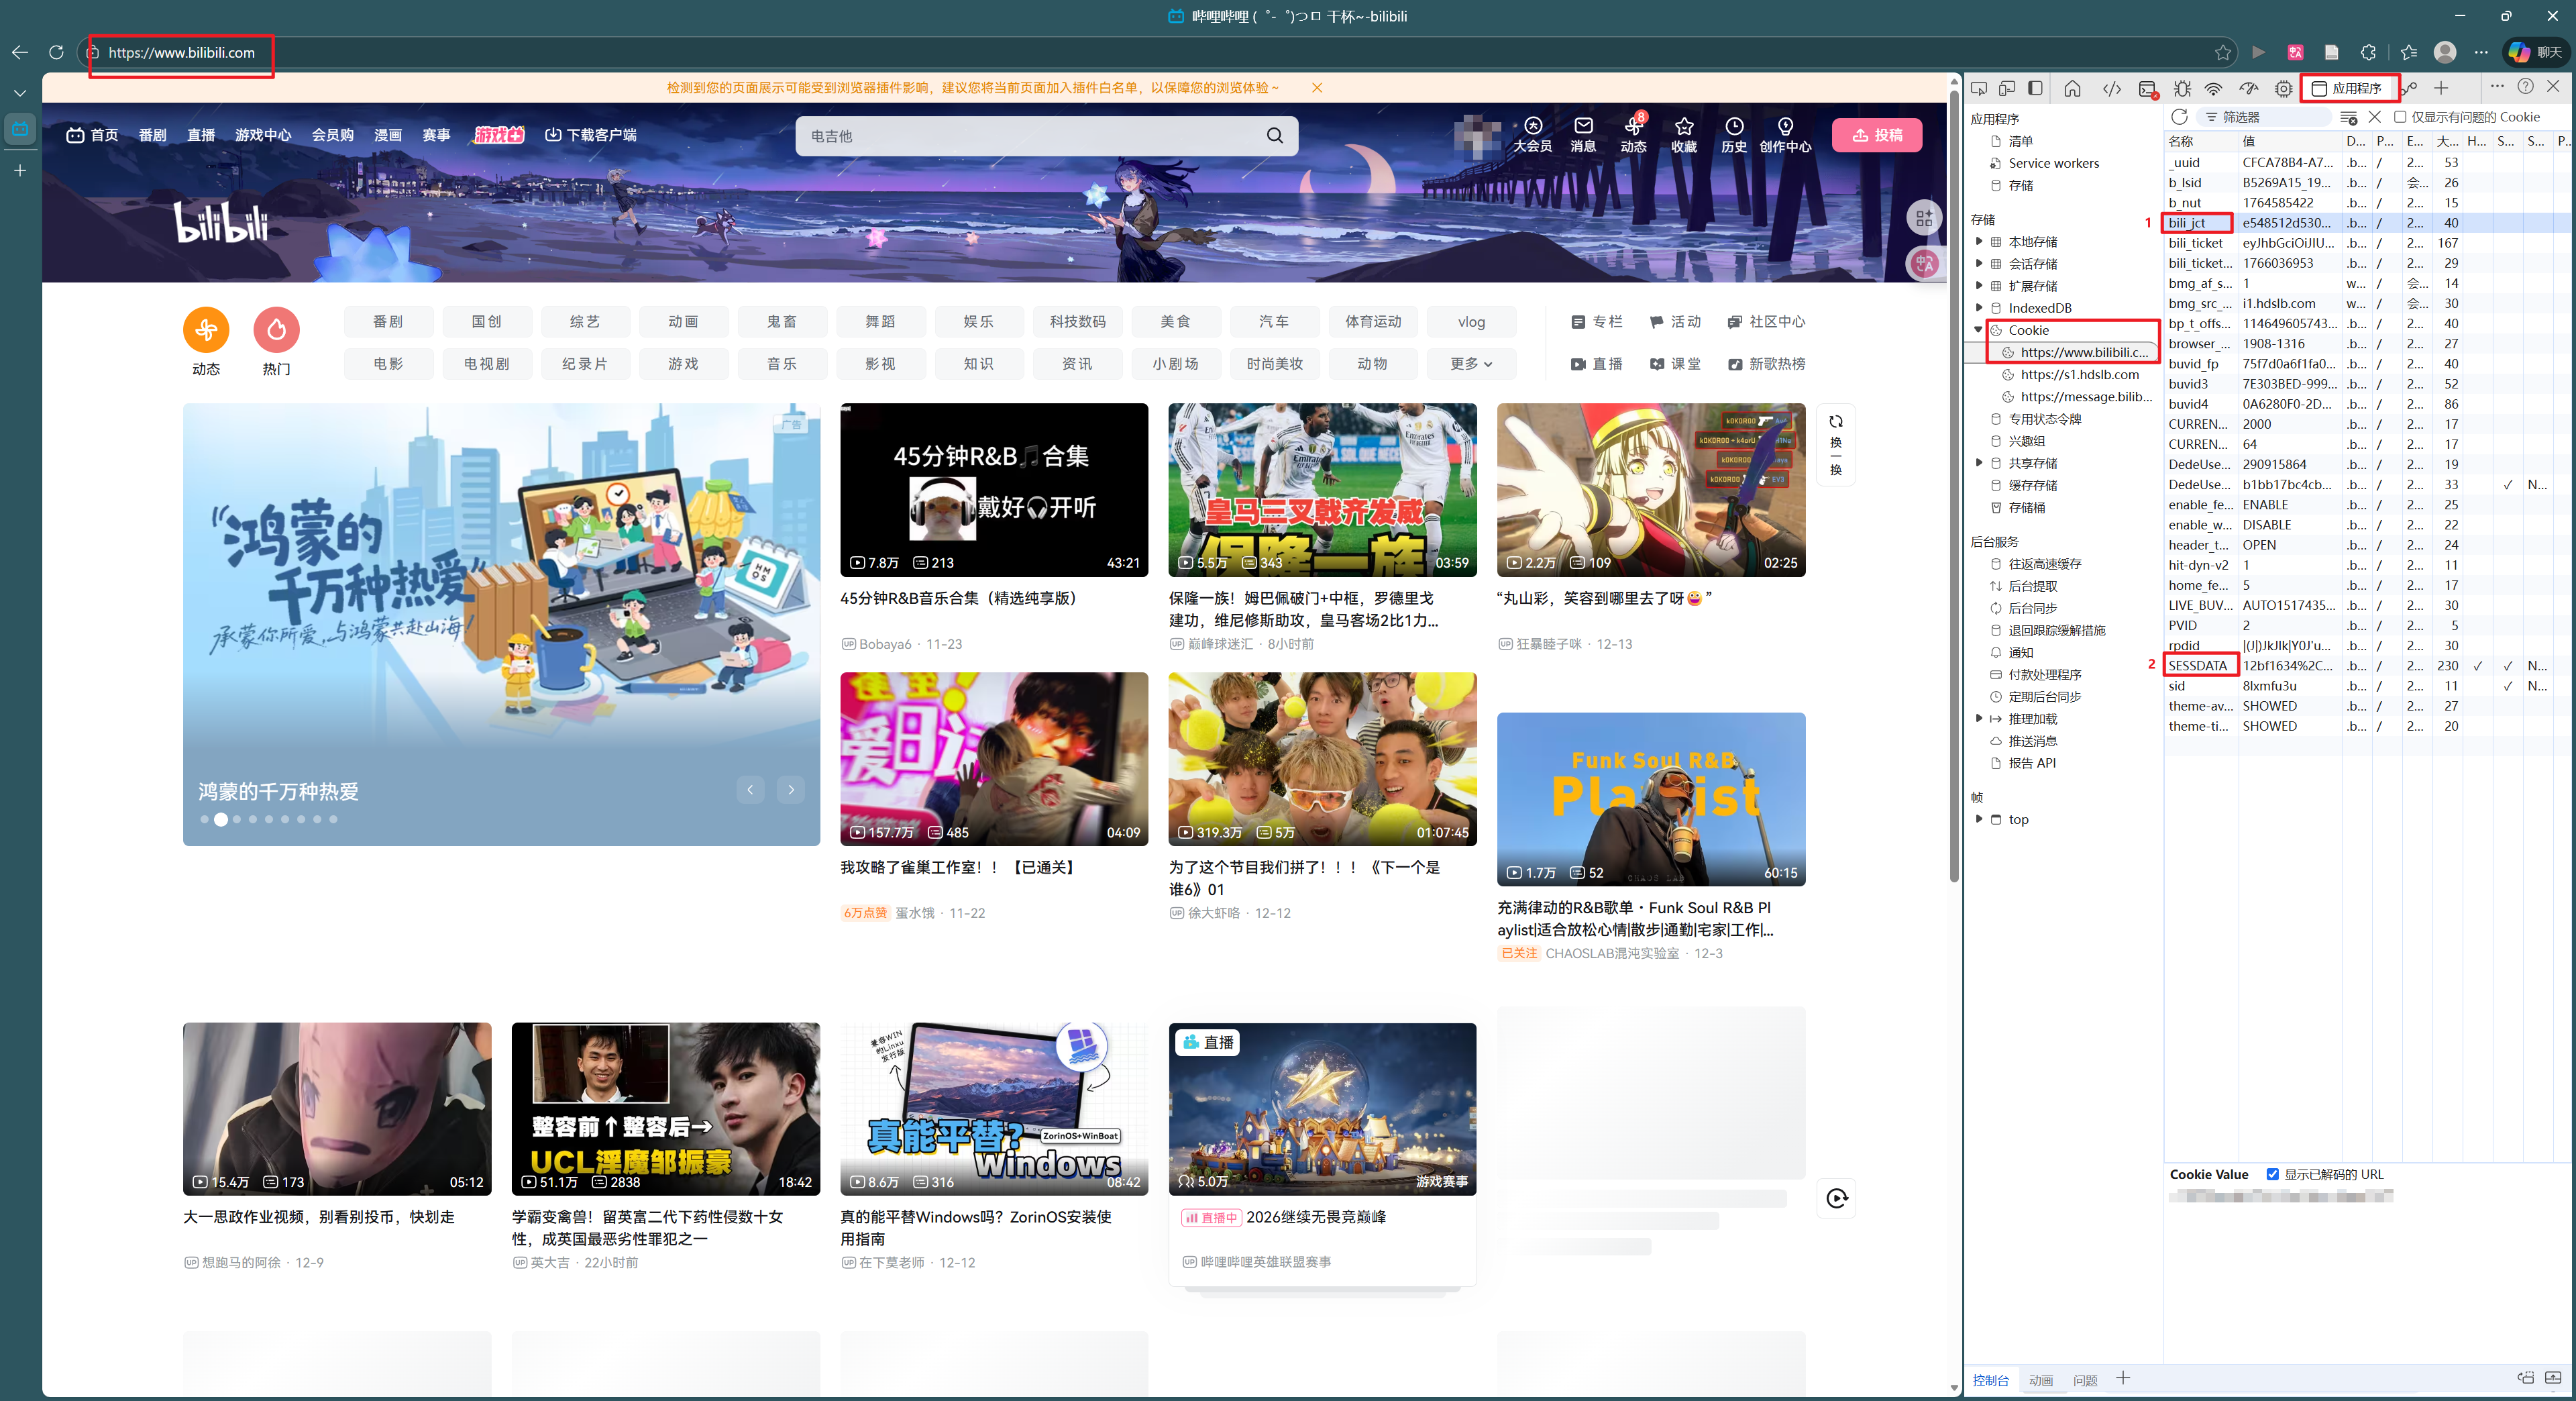
3.1 打开开发者工具(F12)
在B站页面的任意位置,按下键盘上的
F12键。或者,在页面上鼠标右键,选择 “检查”。
3.2 找到“应用程序”或“应用”标签
打开开发者工具后,顶部会有一排选项卡标签(如:元素、控制台、源代码等)。
找到并点击【应用程序】或【应用】。
在 Chrome、Edge、新版Firefox 中叫
应用程序。在 旧版浏览器或某些设置下 可能叫
应用或Storage。(如果没看到,可能被折叠了,可以点击
>>图标查看更多标签)。
3.3 在 应用程序 面板下,左侧有一个侧边栏。
依次展开:
存储->Cookie->https://www.bilibili.com。点击
https://www.bilibili.com后,右侧主区域会显示一个表格,里面列出了所有Cookie的名称和值。
3.4 查找并复制目标Cookie
在右侧表格的
名称列中,慢慢向下滚动查找:找到名称为
SESSDATA的行,点击其值列中的那一长串字符(通常以%结尾),完整地复制下来。找到名称为
bili_jct的行,同样复制其值列中的字符(一串较短的字母数字组合)。